Screaming Frog CLI et APIPlanifier et automatiser vos crawls
Screaming Frog n’est pas qu’une interface graphique. Son mode ligne de commande et ses connexions API permettent de lancer, planifier et industrialiser vos audits sans lever le petit doigt.
 Lucas Fonsequecréateur de sites webPublié le 29 juillet 2026Dernière modification le 13 octobre 202615 min de lecture
accompagnés


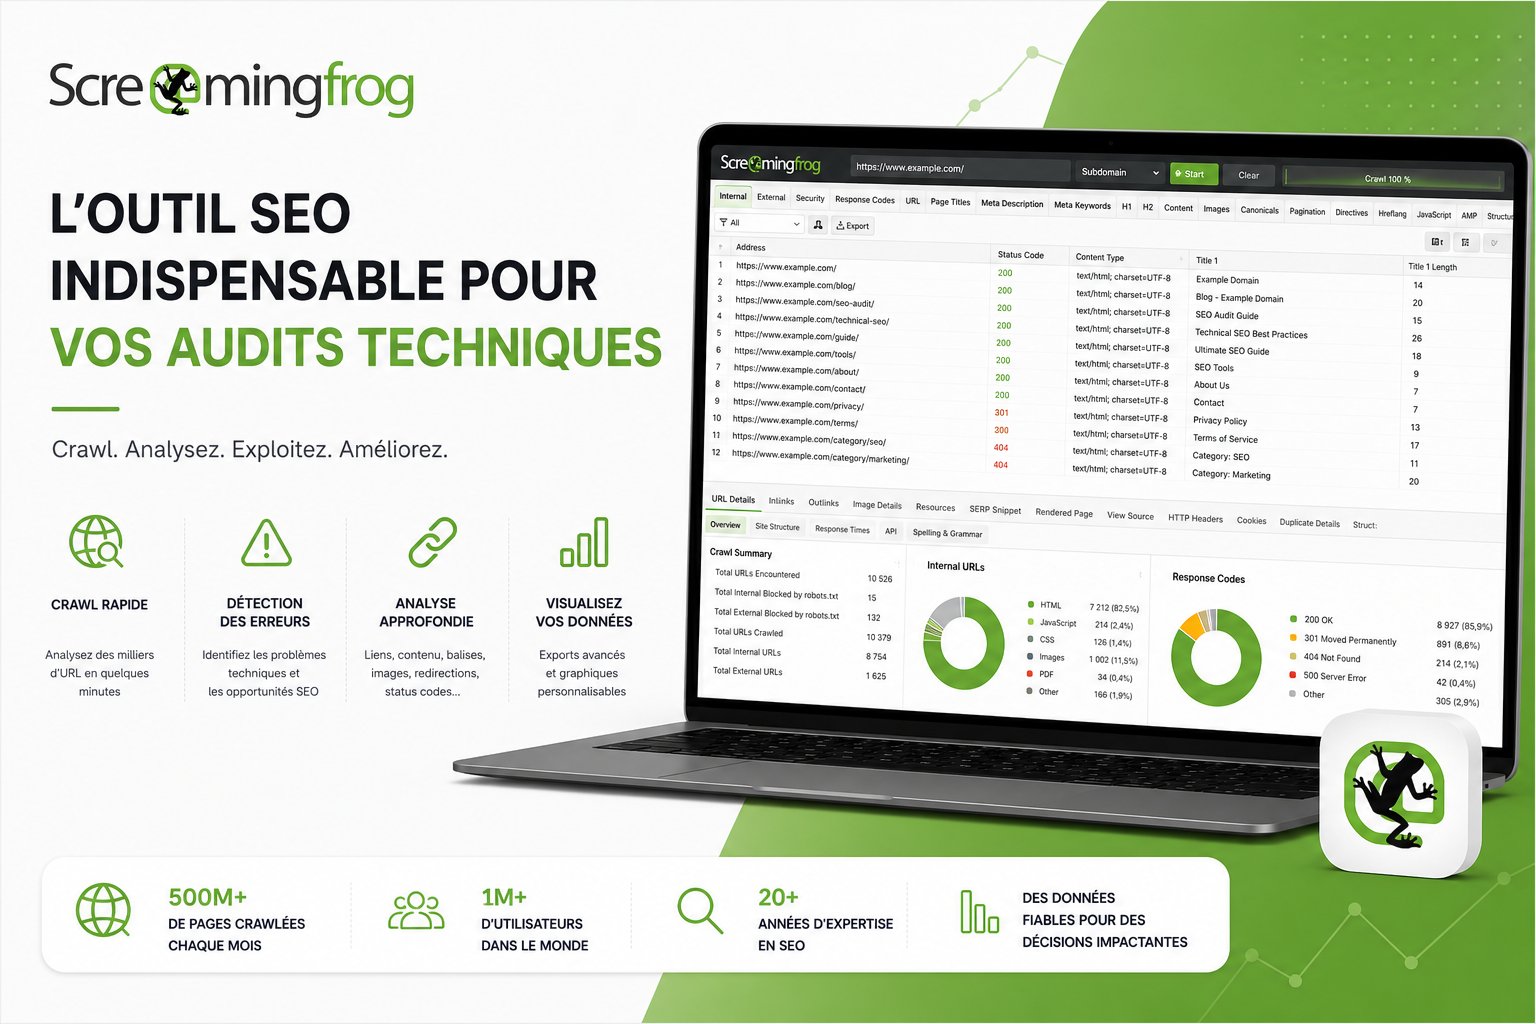
Screaming Frog propose un mode ligne de commande (CLI) qui permet de lancer un crawl sans ouvrir l’interface graphique. Vous déclenchez un audit via une simple commande, avec une configuration prédéfinie, et l’outil exporte automatiquement les résultats dans le dossier de votre choix.
Couplé à la planification intégrée et aux connexions API (Search Console, Analytics, PageSpeed, IA), cela transforme Screaming Frog en outil d’automatisation : des crawls récurrents, des rapports générés seuls, sans intervention manuelle.
Pourquoi automatiser vos crawls Screaming Frog ?
Lancer un crawl à la main, attendre, puis exporter les données, cela va très bien pour un audit ponctuel. Mais dès que vous devez surveiller un site en continu, ou auditer régulièrement des dizaines de sites, la répétition manuelle devient un frein. L’automatisation résout ce problème.
Avec le mode ligne de commande et la planification, vous définissez une fois votre configuration, puis Screaming Frog s’exécute seul, aux horaires que vous choisissez. Un crawl chaque nuit, un rapport chaque lundi matin, une surveillance des erreurs en continu : tout devient possible sans vous asseoir devant l’interface.
Le gain n’est pas seulement du temps économisé. L’automatisation apporte de la régularité et de la fiabilité. Un humain oublie, reporte, se trompe de configuration ; une tâche planifiée exécute exactement la même opération à chaque fois. Vous obtenez des données comparables d’une semaine à l’autre, ce qui rend possible le suivi des tendances : le nombre d’erreurs augmente-t-il, la profondeur du site se dégrade-t-elle, de nouvelles pages orphelines apparaissent-elles ?
Cette régularité change aussi votre façon de travailler. Au lieu de découvrir un problème des semaines après son apparition, lors du prochain audit manuel, vous êtes alerté rapidement grâce à une surveillance continue. Un lot de pages qui bascule en erreur 404 après une mise en production, une balise noindex ajoutée par erreur sur tout un répertoire : ce sont des incidents que le monitoring automatisé repère avant qu’ils ne coûtent du trafic.
Enfin, l’automatisation libère du temps pour les tâches à forte valeur. Le crawl, l’export et la mise en forme des données sont des opérations mécaniques qui n’apportent aucune valeur ajoutée tant qu’elles sont faites à la main. En les déléguant à la machine, vous réservez votre énergie à ce que vous seul pouvez faire : comprendre le contexte, arbitrer les priorités et construire une stratégie. C’est un changement d’échelle autant qu’un gain de confort.
C’est le prolongement naturel des intégrations IA de Screaming Frog : une fois vos prompts et vos connexions configurés, l’automatisation les rejoue à volonté, en boucle, sans effort supplémentaire.
Le mode ligne de commande expliqué simplement
Le mode ligne de commande, ou CLI, permet de piloter Screaming Frog sans son interface graphique. Au lieu de cliquer, vous tapez une commande dans un terminal en précisant l’URL à crawler, la configuration à utiliser et le dossier de sortie. L’outil s’exécute alors en arrière-plan et exporte tout seul.
Le principe repose sur deux éléments. D’abord une configuration sauvegardée : dans l’interface, vous réglez tout ce dont vous avez besoin, exclusions, extractions personnalisées, connexions API, puis vous enregistrez ce paramétrage dans un fichier. Ensuite la commande elle-même, qui appelle ce fichier de configuration et précise l’URL à auditer. Vous séparez ainsi le réglage, fait une fois dans le confort de l’interface, de l’exécution, répétée autant de fois que vous voulez en une ligne.
Le mode sans interface, souvent appelé headless, est particulièrement utile. Il permet de lancer un crawl sur une machine sans écran, comme un serveur distant. C’est ce qui autorise les crawls tournés en arrière-plan, la nuit, ou sur une infrastructure dédiée qui n’a pas besoin d’un affichage graphique. Le crawl s’exécute, exporte ses résultats, et se termine sans qu’aucune fenêtre ne s’ouvre.
Il ne faut pas confondre la ligne de commande avec l’API d’un service en ligne. Ici, tout tourne en local, sur votre propre machine ou votre serveur : Screaming Frog reste un logiciel de bureau, mais vous le pilotez par commande plutôt que par clics. Cette distinction rassure souvent : vos données de crawl ne transitent par aucun service tiers, elles restent sur votre infrastructure, ce qui simplifie la question de la confidentialité par rapport à des outils cloud.
Cette fonction est réservée à la version payante. Elle s’adresse aux SEO techniques et aux agences qui gèrent de nombreux sites : au lieu d’ouvrir l’application pour chaque audit, ils scriptent l’ensemble. C’est aussi la brique de base pour intégrer Screaming Frog dans un pipeline automatisé plus large.
Voici à quoi ressemble le lancement d’un crawl en ligne de commande : l’adresse à explorer, le mode sans interface, l’enregistrement du crawl et le dossier où déposer les exports. L’adresse et le dossier sont des exemples, à adapter à votre site.
# crawl automatisé avec export des résultats
ScreamingFrogSEOSpiderCli --crawl https://exemple.fr
--headless --save-crawl --output-folder /rapports/
Crawl terminé : 1 240 URLs, export enregistré
# --headless lance le crawl sans interface graphique
Les options de commande à connaître
La commande de base se complète de plusieurs options qui déterminent le comportement du crawl. L’option qui désigne l’URL de départ est évidemment centrale, mais ce sont les paramètres qui l’accompagnent qui donnent toute sa puissance à l’automatisation. Vous pouvez pointer vers un fichier de configuration sauvegardé, choisir un dossier de sortie, ou demander l’export de rapports précis.
Le paramètre de configuration est le plus important. En lui passant un fichier réglé à l’avance dans l’interface, vous garantissez que le crawl automatisé se comporte exactement comme votre crawl manuel : mêmes exclusions, mêmes extractions personnalisées, mêmes connexions API activées. Sans lui, la commande utiliserait la configuration par défaut, souvent trop générique pour un audit sérieux.
D’autres options pilotent les exports. Vous pouvez demander à Screaming Frog d’enregistrer le fichier de crawl complet pour le rouvrir plus tard, ou d’exporter directement certains onglets et rapports au format tableur. Cette dernière possibilité est précieuse en automatisation : le crawl produit directement les fichiers exploitables, sans qu’il faille rouvrir l’interface pour les générer à la main.
Une astuce utile est de conserver vos commandes dans un fichier documenté, avec un court commentaire expliquant ce que chacune fait. Sur la durée, vous constituez ainsi une boîte à outils de crawls prêts à l’emploi, que vous adaptez en changeant simplement l’URL ou le fichier de configuration. C’est un gain de temps considérable quand vous multipliez les sites à auditer, et cela réduit nettement le risque d’erreur humaine à chaque nouvelle mise en place.
La bonne approche consiste à préparer et tester votre commande sur un petit site avant de l’intégrer dans une tâche planifiée. Vous vérifiez que la configuration est bien prise en compte, que les exports arrivent au bon endroit et dans le bon format, puis seulement vous automatisez. Cette étape de validation évite de découvrir un crawl mal configuré qui aurait tourné à vide pendant des semaines.
Planifier des crawls automatiques
Au-delà de la ligne de commande, Screaming Frog intègre une planification directement dans l’interface. Vous créez une tâche planifiée en choisissant le site, la configuration, la fréquence (quotidienne, hebdomadaire, mensuelle) et le dossier d’export. L’outil se lance ensuite tout seul aux moments définis.
L’avantage de cette planification intégrée est qu’elle ne demande aucune compétence en ligne de commande. Tout se fait par une interface de configuration classique, avec des menus déroulants et des cases à cocher. Un SEO qui n’a jamais ouvert un terminal peut mettre en place un crawl hebdomadaire automatique en quelques minutes. C’est la porte d’entrée la plus accessible vers l’automatisation.
Le choix des horaires a son importance. Un crawl consomme des ressources sur votre poste ou votre serveur et génère des requêtes vers le site audité. Le planifier la nuit, en dehors des heures de forte affluence, évite de peser sur les performances du serveur cible et libère votre machine pendant la journée. Pour un site à fort trafic, cette attention au moment du crawl fait partie des bonnes pratiques.
Cette planification peut aussi exporter automatiquement vers Google Sheets ou déclencher des rapports. Combinée aux connexions API, elle produit des audits enrichis sans intervention : positions, trafic, performances et erreurs réunis dans un même export généré pendant que vous dormez.
| Connexion API | Données récupérées | Usage typique |
|---|---|---|
| Google Search Console | Clics, impressions, positions | Croiser crawl et performance réelle |
| Google Analytics | Trafic et engagement par page | Prioriser selon l’audience |
| PageSpeed Insights | Core Web Vitals, vitesse | Auditer la performance à l’échelle |
| Modèles d’IA | Analyses générées par LLM | Enrichir chaque page automatiquement |
Les connexions Google demandent l’autorisation de votre compte, les modèles d’IA une clé d’API : préparez-les avant de planifier le crawl.
Les connexions API intégrées
Screaming Frog se connecte nativement à plusieurs API Google pendant le crawl. La Search Console remonte les clics et positions de chaque URL, Analytics ajoute les données de trafic, et PageSpeed Insights injecte les Core Web Vitals. Vous obtenez une vue unique mêlant structure technique et performance réelle.
Cette fusion des données est ce qui rend l’audit vraiment actionnable. Une page peut être techniquement parfaite mais ne générer aucun trafic, ou au contraire ramener des clics tout en souffrant d’un problème technique invisible. En croisant la structure remontée par le crawl avec les performances réelles issues de la Search Console et d’Analytics, vous identifiez immédiatement les pages à fort potentiel qui sont bridées par un défaut technique, ou les pages parfaites mais inutiles que personne ne visite.
La connexion PageSpeed Insights mérite une mention particulière. Elle permet de récupérer les Core Web Vitals de chaque URL directement dans le tableau de crawl, là où il faudrait sinon tester les pages une par une dans l’outil de Google. Sur un gros site, obtenir la vitesse et les indicateurs d’expérience de milliers de pages en une opération transforme complètement l’audit de performance, qui devient exhaustif au lieu d’être limité à quelques pages échantillons.
La connexion aux modèles d’IA vient compléter ce tableau. Au-delà des données chiffrées de Google, elle ajoute une couche d’analyse qualitative directement dans le crawl : classification des pages, évaluation du contenu, suggestions d’amélioration. Combinée aux API de performance, elle offre une lecture complète de chaque URL, à la fois technique, statistique et éditoriale, en une seule opération automatisée.
Ces connexions se paramètrent une fois, via une autorisation OAuth ou une clé d’API, puis se rejouent à chaque crawl. Associées à la planification, elles alimentent des tableaux de bord toujours à jour. C’est ce qui distingue un audit ponctuel d’un véritable monitoring SEO continu.
Ligne de commande
Lancez un crawl complet d’une seule commande, sans ouvrir l’interface graphique.
Crawls planifiés
Programmez des audits récurrents, quotidiens ou hebdomadaires, en export automatique.
Connexions API
Search Console, Analytics, PageSpeed et IA branchés directement au crawl.
Intégrer Screaming Frog dans un pipeline
Pour les usages les plus avancés, le mode ligne de commande permet d’intégrer Screaming Frog dans un pipeline automatisé plus large. Un script déclenche le crawl, récupère les exports, les traite avec un autre outil, et alimente un tableau de bord ou une alerte. Le crawl devient une brique parmi d’autres dans une chaîne de traitement.
Concrètement, un pipeline typique enchaîne plusieurs étapes. Un planificateur système déclenche la commande Screaming Frog à heure fixe. Le crawl s’exécute et dépose ses exports dans un dossier. Un second script récupère ces fichiers, filtre les lignes qui l’intéressent, par exemple uniquement les pages en erreur, et pousse le résultat vers une base de données ou un tableau de bord. Une dernière étape peut envoyer une alerte par email ou message si un seuil est dépassé.
L’intérêt de cette architecture est qu’elle tourne sans supervision. Une fois en place, elle produit chaque jour ou chaque semaine un état de santé du site, historisé et comparé dans le temps. Pour une agence qui gère des dizaines de clients, c’est la différence entre auditer chaque site à la main de temps en temps et disposer d’un monitoring permanent qui remonte les problèmes dès qu’ils surviennent, sur l’ensemble du portefeuille.
La mise en place demande toutefois de la rigueur. Un pipeline mal conçu peut passer inaperçu lorsqu’il tombe en panne : le crawl échoue silencieusement, les exports ne se génèrent plus, et personne ne s’en rend compte avant qu’un problème réel ne surgisse. C’est pourquoi un bon pipeline surveille aussi sa propre exécution : il signale non seulement les anomalies du site, mais aussi ses propres défaillances, pour qu’on puisse lui faire confiance dans la durée.
Cette approche s’adresse aux équipes techniques et aux agences qui industrialisent leur SEO. Elle demande un investissement initial de mise en place, mais le gain de temps sur la durée est considérable. C’est la dernière étape du parcours pour les profils avancés, décrit dans mon guide de formation Screaming Frog.
Des cas concrets d’automatisation SEO
Pour rendre tout cela tangible, voici quelques scénarios d’automatisation courants. Le premier est la surveillance des erreurs. Un crawl quotidien programmé sur le site principal remonte chaque matin les nouvelles pages en 404, les redirections cassées et les erreurs serveur. Le rapport arrive avant l’ouverture des bureaux : l’équipe corrige les incidents de la veille avant qu’ils ne pèsent sur le référencement.
Deuxième scénario : le suivi des balises et des contenus. Un crawl hebdomadaire vérifie que les titres et meta descriptions restent uniques et bien renseignés, que les balises canoniques pointent au bon endroit, et qu’aucune page importante n’a basculé en noindex par accident. Sur un gros site alimenté par plusieurs contributeurs, ce garde-fou automatique évite les dérives silencieuses qui, cumulées, finissent par coûter cher.
Troisième scénario : l’audit récurrent de portefeuille pour une agence. Une tâche planifiée passe sur l’ensemble des sites clients une fois par semaine, exporte les indicateurs clés dans un tableau de bord partagé, et signale les sites dont la santé technique se dégrade. Le professionnel du SEO arrive le lundi avec une vue synthétique de tout son portefeuille, sans avoir lancé le moindre crawl à la main.
Un quatrième scénario, plus stratégique, concerne le suivi après une migration ou une refonte. Ce sont des moments à haut risque pour le référencement : redirections oubliées, pages disparues, balises modifiées. Programmer des crawls rapprochés dans les jours qui suivent la mise en ligne permet de détecter immédiatement toute régression et d’intervenir avant que Google ne pénalise le site. L’automatisation devient ici un filet de sécurité sur une opération critique.
Ces exemples ont un point commun : ils transforment un travail ponctuel et facile à oublier en un processus fiable qui tourne tout seul. C’est exactement ce que permet l’automatisation, et c’est pourquoi elle est devenue un standard chez les SEO techniques et les agences structurées.
Un suivi dans le cloud, à côté de vos crawls
Screaming Frog automatise le crawl sur votre machine ou votre serveur. Semrush, lui, tourne dans le cloud : son audit de site explore vos pages et croise les erreurs avec vos positions et vos mots-clés suivis. L’essai gratuit de 7 jours donne accès aux formules payantes, puis Semrush démarre à 139,95 $ par mois.
Lien partenaire : si vous vous abonnez, je touche une commission, sans surcoût pour vous.
Ce que l’automatisation ne fait pas à votre place
L’automatisation lance les crawls et rassemble les données, mais elle ne remplace pas l’analyse. Un crawl planifié qui remonte trois cents erreurs ne sert à rien si personne ne les lit ni ne les corrige. L’outil produit la matière première ; l’intelligence reste dans l’interprétation et la décision.
Il y a même un piège à éviter : l’illusion de contrôle. Mettre en place un beau tableau de bord automatisé donne le sentiment que le sujet est traité, alors que les données ne servent à rien tant que personne ne les regarde ni n’agit dessus. Un rapport qui s’accumule dans un dossier sans jamais être lu ne vaut pas mieux que l’absence de rapport. L’automatisation n’a de valeur que couplée à un temps humain réservé à l’exploitation des résultats.
Une bonne pratique consiste à automatiser aussi l’alerte, pas seulement la collecte. Plutôt que de recevoir chaque semaine un gros export à éplucher, vous configurez des seuils, pour être prévenu uniquement si le nombre d’erreurs dépasse tel chiffre, ou si une page stratégique disparaît de l’index. Ainsi, l’attention humaine se porte sur les événements qui comptent, au lieu de se noyer dans un flot de données normales.
Le bon réflexe est d’automatiser la collecte et l’alerte, puis de garder un temps humain d’analyse. Vous recevez un rapport propre chaque semaine, vous l’examinez, vous priorisez. L’automatisation vous libère du travail mécanique pour vous concentrer sur ce qui compte vraiment : arbitrer et agir.
Mon verdict sur l’automatisation de Screaming Frog
Le mode ligne de commande, la planification et les connexions API font de Screaming Frog un véritable outil d’automatisation SEO, pas seulement un crawler manuel. Pour les agences et les SEO techniques qui gèrent plusieurs sites, c’est un gain de temps majeur qui transforme l’audit ponctuel en monitoring continu.
Mon conseil pour démarrer : commencez par automatiser un seul crawl récurrent sur votre site principal, avec un export vers Google Sheets. Une fois le mécanisme maîtrisé, étendez-le à vos autres sites et ajoutez les connexions API une par une.
Un site simple à surveiller
Un crawl automatique repère vite les erreurs, un site bien construit en produit moins. Je crée des sites WordPress clairs et rapides, pour les indépendants et les petites entreprises : un site vitrine commence à 1 500 € HT. Tout est expliqué sur la page création de site internet.
Questions fréquentes sur l’automatisation de Screaming Frog
Une autre question ? Décrivez votre projet, on vous répond par mail.
Le mode ligne de commande est-il disponible en version gratuite ?
Non, le mode ligne de commande et la planification sont réservés à la version payante de Screaming Frog. La version gratuite se limite à l’interface graphique et à 500 URLs par crawl.
Pour un usage d’automatisation régulier, la licence annuelle (199 £ par an et par utilisateur, soit 279 $ ou environ 245 €) est vite rentabilisée par le temps gagné. Dès que vous auditez plusieurs sites ou que vous mettez en place un monitoring continu, elle devient indispensable.
Faut-il savoir coder pour automatiser Screaming Frog ?
La planification intégrée se configure entièrement dans l’interface, sans code. Le mode ligne de commande demande d’être à l’aise avec un terminal, et l’intégration dans un pipeline complet requiert des compétences techniques plus poussées.
Autrement dit, il existe plusieurs niveaux d’automatisation accessibles selon votre profil. Vous pouvez commencer par la planification sans une ligne de code, puis monter en compétence progressivement vers la ligne de commande et les pipelines si le besoin s’en fait sentir.
Quelles API Screaming Frog peut-il connecter ?
Nativement, Google Search Console, Google Analytics et PageSpeed Insights, ainsi que les modèles d’IA comme OpenAI et Gemini. Ces connexions enrichissent chaque page crawlée avec des données de performance et d’analyse.
Chaque connexion se configure une seule fois, via une autorisation Google ou une clé d’API, puis elle se rejoue automatiquement à chaque crawl. Vous pouvez les activer toutes ou n’en choisir que certaines selon les données dont vous avez besoin pour votre audit.
Peut-on planifier des crawls automatiques ?
Oui, Screaming Frog intègre un planificateur : vous choisissez le site, la configuration, la fréquence et le dossier d’export, et l’outil lance les crawls tout seul, avec export automatique possible vers Google Sheets.
Sur quelle machine faire tourner des crawls automatisés ?
Pour des crawls ponctuels, votre poste de travail suffit. Mais pour un monitoring continu, il vaut mieux dédier une machine qui reste allumée, comme un serveur ou une machine virtuelle. Le mode sans interface permet justement de faire tourner Screaming Frog sur un serveur distant sans écran.
Pensez simplement à dimensionner la mémoire de la machine en fonction de la taille des sites à crawler : un crawl volumineux consomme beaucoup de RAM, surtout en mode mémoire plutôt qu’en mode base de données sur disque.
L’automatisation peut-elle surcharger le site audité ?
Oui, si vous ne fixez pas de limite. Un crawl agressif envoie beaucoup de requêtes et peut ralentir un serveur fragile. Screaming Frog permet de régler la vitesse de crawl et le nombre de requêtes simultanées : sur un site sensible, réduisez ces valeurs et planifiez le crawl en heures creuses pour ne pas dégrader l’expérience des visiteurs.
À quelle fréquence programmer un crawl automatique ?
Cela dépend de la taille et de la vivacité du site. Un site qui publie beaucoup et évolue vite gagne à être crawlé chaque jour pour détecter rapidement les incidents. Un site stable et de taille modeste se contente d’un crawl hebdomadaire, voire mensuel.
Le bon réflexe est d’adapter la fréquence à l’enjeu : surveillance quotidienne des erreurs critiques sur les pages stratégiques, audit complet plus espacé. Multiplier les crawls inutiles consomme des ressources machine sans apporter la moindre information nouvelle.
Comment recevoir une alerte quand un problème apparaît ?
Screaming Frog seul ne gère pas les alertes actives, mais son export automatisé s’intègre facilement dans un pipeline qui, lui, envoie des notifications. En plaçant un script qui lit l’export après chaque crawl et vérifie des seuils, vous déclenchez un email ou un message dès qu’une condition est remplie : trop d’erreurs, une page clé disparue, un temps de réponse dégradé. C’est ce couplage entre crawl automatisé et alerte qui transforme l’outil en véritable système de surveillance.
Ce que disent mes clients
Des avis publiés sur Google et des recommandations publiées sur LinkedIn.
« Simple et efficace, Lucas à compris à merveille le besoin de mon activité pour me faire un site internet au top et dans un temps record. »
« Je recommande vivement Lucas. Il a réalisé la refonte complète de mon site (…) Professionnel et efficace, je suis ravi de cette collaboration. Merci ! »
« (…) Il est bien réel, disponible, efficace et humain ! Il prend soin de la visibilité de notre petite association. (…) »
« Lucas est un expert de la création d’entreprise et de tous les orbites qui tournent autour. (…) il a pressé mon jus de crâne pour la bonne cause tout en m’inspirant. Merci Lucas que je recommande vivement :) »
« Lucas est super efficace (…) Au delà d’être agréable et gentil, il cerne les problématiques très rapidement. (…) J’ai beaucoup apprécié sa pédagogie (…) »
« Lucas est un élément brillant et transmet une belle énergie à tout groupe de travail. Nous avons travaillé ensemble sur des sujets communs et organisationnels de nos entreprises respectives. Merci à lui pour ses idées disruptives. A très vite »
« (…) Très attaché à la qualité et aux résultats, Lucas sait se montrer ambitieux et donner le meilleur pour aller au bout de ses projets. (…) »
« Je tiens à recommander Lucas pour son professionnalisme. (…) »
Des avis publiés, pas inventés
Les avis Google ont tous reçu cinq étoiles. Les recommandations viennent de LinkedIn. Tout est repris tel que les personnes l’ont écrit. Quand un passage est coupé, il est signalé par (…).
À lire aussi
Lucas Fonseque, créateur de sites web
Je suis entrepreneur, et je travaille dans le digital depuis dix ans. J’ai d’abord appris à programmer. Puis j’ai lancé mes propres projets : une marque, des boutiques en ligne, une plateforme, une communauté de plus de 600 entrepreneurs, une application. Je sais comment le web fonctionnait hier, et comment il fonctionne aujourd’hui.
J’ai travaillé pour des indépendants, des petites entreprises, des start-up et des grands comptes. Je me tiens à jour en permanence, parce que les outils changent vite. C’est toute cette expérience que vous retrouvez dans votre site. Vous pouvez lire mon histoire en entier, voir mes réalisations ou parcourir tous mes services.
Un site à créer ou à refaire ?
Vous n’avez rien à préparer. Décrivez votre projet en deux minutes, on vous répond par mail.
Vous décrivez votre projet. Deux minutes suffisent.
On vous répond par mail, puis on voit ensemble la suite.
Vous recevez un devis détaillé et gratuit, sans engagement.