Screaming Frog Log File AnalyserLire les logs comme Googlebot
Le crawl vous dit ce que votre site expose. Les logs serveur vous disent ce que Googlebot fait vraiment. Voici comment croiser les deux avec l’outil de log de Screaming Frog.
 Lucas Fonsequecréateur de sites webPublié le 29 juillet 2026Dernière modification le 24 octobre 202615 min de lecture
accompagnés


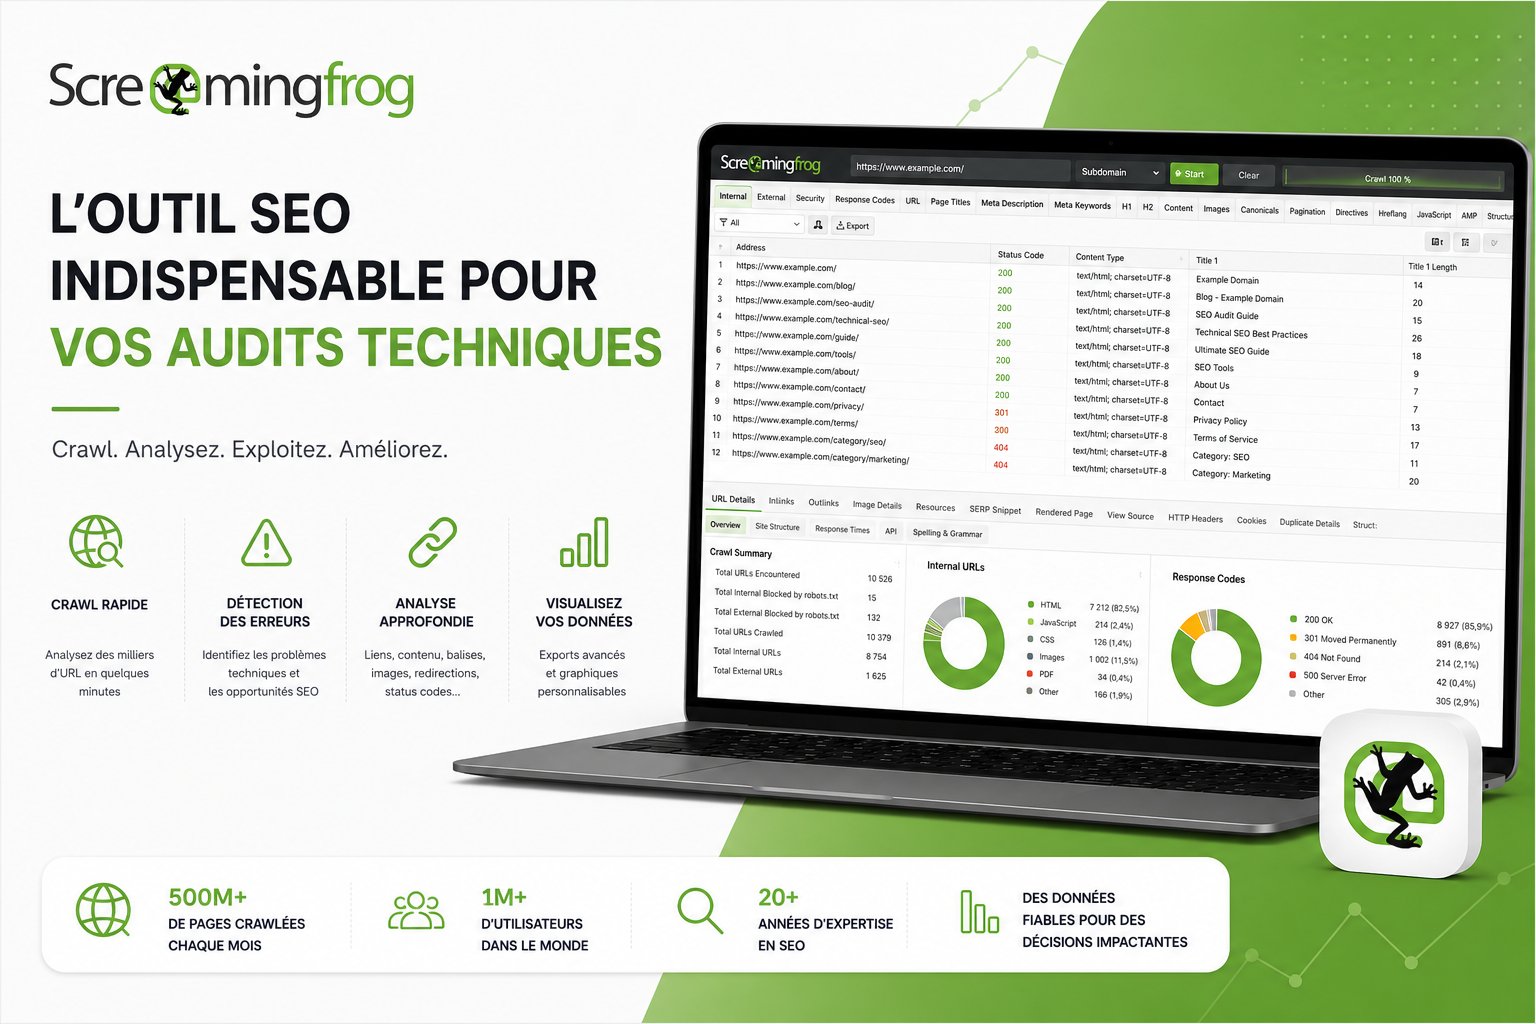
Le Screaming Frog Log File Analyser est un logiciel distinct du SEO Spider. Il ne crawle pas votre site : il lit vos fichiers de logs serveur pour vous montrer exactement quelles URLs Googlebot visite, à quelle fréquence, et quels codes réponse il rencontre.
C’est l’outil qui révèle votre budget de crawl réel. Vous passez des suppositions aux faits : vous voyez enfin ce que les moteurs explorent vraiment, et surtout ce qu’ils ignorent.
Pourquoi analyser vos logs serveur ?
Un crawl avec le SEO Spider simule le comportement d’un robot : il suit vos liens et découvre vos pages comme le ferait Google, en théorie. Mais il reste une simulation. Les logs serveur, eux, enregistrent chaque requête réelle reçue par votre site, y compris celles de Googlebot. C’est la seule source de vérité absolue sur ce que les moteurs font concrètement chez vous.
Prenez une image simple : le crawl, c’est le plan d’un bâtiment ; les logs, ce sont les caméras de surveillance qui montrent par où les visiteurs passent vraiment. Le plan vous dit ce qui est possible ; les caméras vous disent ce qui se passe. Un couloir magnifiquement conçu mais que personne n’emprunte ne sert à rien. En SEO, une page parfaite que Googlebot ne visite jamais est exactement ce couloir désert.
Le Screaming Frog Log File Analyser lit ces fichiers de logs (format Apache, Nginx, IIS) et transforme des millions de lignes illisibles en tableaux exploitables. Vous voyez quelles pages Googlebot visite le plus, lesquelles il n’a jamais explorées, et où il gaspille votre budget de crawl sur des URLs sans valeur.
La différence est fondamentale et souvent mal comprise. Un audit de crawl vous dit : « voici ce que votre site propose à explorer ». L’analyse de logs vous dit : « voici ce que Google a réellement exploré, quand, et combien de fois ». Entre les deux, il y a presque toujours un écart, et c’est précisément dans cet écart que se cachent les problèmes d’indexation les plus coûteux. Une page magnifique que Googlebot ne visite jamais ne rapportera aucun trafic, peu importe sa qualité.
C’est une source de données qu’aucun autre outil ne peut fabriquer, car elle ne relève pas de l’estimation. La Search Console donne des statistiques d’exploration agrégées, utiles mais limitées. Les logs, eux, contiennent le détail brut, ligne par ligne, URL par URL. C’est la matière première la plus fiable qui existe pour comprendre le comportement des moteurs sur votre site.
Concrètement, si Google passe 40 % de son temps sur des pages de filtres e-commerce inutiles, vos pages stratégiques sont explorées moins souvent. L’analyse de logs met ce gaspillage en lumière. C’est un complément naturel de mon guide du crawl avec le SEO Spider.
Log File Analyser ou SEO Spider : deux outils complémentaires
Beaucoup confondent les deux logiciels. Le SEO Spider crawle votre site pour auditer sa structure, ses balises, ses redirections. Le Log File Analyser ne crawle rien : il consomme des fichiers de logs que votre hébergeur produit déjà. Ce sont deux briques distinctes, vendues et installées séparément.
Cette distinction a une conséquence pratique sur votre licence. Posséder le SEO Spider ne vous donne pas accès au Log File Analyser, et inversement. Chacun a son propre tarif (199 £ par an et par utilisateur pour le SEO Spider, soit 279 $ ou environ 245 €) et sa propre version gratuite limitée. Il faut donc évaluer votre besoin réel avant d’investir dans le second outil : sur un petit site, il ne se justifie pas ; sur une grosse volumétrie, il devient vite indispensable.
La vraie puissance vient quand vous croisez les deux. Vous importez votre crawl du SEO Spider dans le Log File Analyser, et vous obtenez une vue unique : pages crawlables non visitées par Google, pages orphelines pourtant visitées, écarts entre votre structure théorique et la réalité d’exploration. Ce croisement est là où l’analyse prend toute sa dimension stratégique.
Ce que vous découvrez dans vos logs
Une fois vos logs importés, l’outil vous donne accès à des indicateurs impossibles à obtenir autrement. La fréquence de crawl par URL vous montre les pages que Google juge importantes. Les codes réponse réels (200, 301, 404, 500) rencontrés par les bots révèlent des erreurs que votre crawl théorique ne verra jamais.
Un exemple parlant : une page peut renvoyer un beau code 200 quand vous la visitez dans votre navigateur, mais servir un 500 intermittent quand Googlebot la sollicite en masse aux heures de forte charge. Votre crawl ponctuel ne le verra pas ; les logs, qui enregistrent chaque requête sur la durée, captureront ces erreurs sporadiques. Ce sont précisément ces problèmes intermittents, invisibles autrement, qui pénalisent l’indexation sans qu’on comprenne pourquoi.
Vous observez aussi la répartition du crawl par type de bot. Googlebot desktop, Googlebot mobile, Bingbot et les autres n’explorent pas forcément de la même façon. Depuis le passage à l’index mobile-first, vérifier que Googlebot mobile explore bien vos pages importantes est devenu un contrôle essentiel, que seule l’analyse de logs permet de faire précisément.
Vous identifiez aussi les faux Googlebot : des robots qui se font passer pour Google mais viennent d’adresses IP suspectes. L’outil vérifie l’authenticité des user-agents, ce qui aide à détecter le scraping et les tentatives d’exploration malveillantes.
| Indicateur | Ce qu’il révèle | Action SEO |
|---|---|---|
| Fréquence de crawl | Pages jugées prioritaires par Google | Renforcer le maillage des pages sous-visitées |
| Pages non crawlées | URLs jamais visitées par les bots | Vérifier liens internes et sitemap |
| Codes 4xx / 5xx réels | Erreurs rencontrées par Googlebot | Corriger en priorité les erreurs vues par Google |
| Budget de crawl gaspillé | Temps passé sur des URLs sans valeur | Bloquer via robots.txt ou noindex |
| Authenticité des bots | Vrais vs faux Googlebot | Filtrer le trafic robot malveillant |
Ces indicateurs viennent de vos propres logs : ce sont des faits mesurés, pas des estimations.
Comment récupérer et importer vos logs ?
Première étape : obtenir les fichiers de logs. Ils sont produits automatiquement par votre serveur web. Sur un hébergement mutualisé, vous les téléchargez généralement depuis le panneau cPanel, section « Logs bruts ». Sur un serveur dédié ou un VPS, ils se trouvent dans les répertoires classiques d’Apache ou de Nginx.
Selon la configuration, ces fichiers portent des noms comme access.log ou access_log, parfois datés et compressés au format gzip. Chaque ligne suit un format standard qui comprend l’adresse IP du visiteur, la date et l’heure, la méthode et l’URL demandées, le code de réponse et le user-agent. C’est ce dernier champ qui permet d’identifier Googlebot et de le distinguer du trafic humain ou des autres robots.
Un conseil pratique sur la période : visez au minimum sept jours de logs, idéalement trente. Sur une seule journée, les chiffres de fréquence sont trop bruités pour être exploitables ; Googlebot peut avoir un comportement atypique un jour donné. Sur un mois complet, les tendances se lissent et vous voyez vraiment quelles sections il privilégie et lesquelles il délaisse. Pensez donc à archiver régulièrement vos logs si votre hébergeur les efface vite.
Ensuite, vous glissez simplement les fichiers dans le Log File Analyser. L’outil accepte les formats compressés et fusionne plusieurs jours de logs. Un projet se crée, les données s’indexent, et vous commencez à explorer. Plus vous importez de jours, plus l’analyse de fréquence est fiable.
Voici un extrait simplifié d’un fichier de log serveur, avec trois visites de Googlebot.
# une ligne de log = une requête reçue par le serveur
66.249.66.1 [15/Jul/2026:08:14:22] "GET /blog/audit-seo/ HTTP/1.1" 200
66.249.66.1 [15/Jul/2026:08:14:25] "GET /produit/filtre?couleur=x HTTP/1.1" 200
66.249.66.1 [15/Jul/2026:08:14:31] "GET /page-supprimee/ HTTP/1.1" 404
# le Log File Analyser agrège ces lignes par URL et par bot
Optimiser votre budget de crawl grâce aux logs
Le budget de crawl est le nombre de pages que Google accepte d’explorer sur votre site dans un temps donné. Sur les gros sites, il est limité : chaque URL inutile explorée est une URL stratégique de moins visitée. L’analyse de logs est le seul moyen de mesurer ce budget avec précision.
Google détermine ce budget en fonction de deux facteurs : la capacité de votre serveur à répondre vite sans saturer, et l’intérêt qu’il porte à votre site. Un site rapide et souvent mis à jour sera crawlé plus généreusement qu’un site lent et statique. Améliorer votre temps de réponse serveur peut donc, indirectement, augmenter la fréquence d’exploration, ce que vous constaterez justement dans vos logs au fil des semaines.
Le schéma typique que l’on rencontre souvent : un site e-commerce dont 60 % du budget de crawl part sur des URLs à paramètres, des combinaisons de filtres, des variantes de tri, des pages de pagination profonde. Pendant ce temps, les fiches produits récemment mises à jour ne sont revisitées qu’une fois par mois. Résultat : les nouveautés mettent des semaines à remonter dans les résultats. Sans logs, ce problème reste totalement invisible et on l’attribue à tort au contenu ou aux backlinks.
La navigation à facettes est le coupable numéro un sur les gros catalogues. Chaque combinaison de filtres, taille, couleur, marque, prix, génère une URL unique que Googlebot peut explorer. Sur un catalogue conséquent, cela produit des dizaines de milliers d’URLs de faible valeur qui n’existent que pour l’utilisateur, pas pour l’index. Les logs chiffrent précisément le temps que Google y consacre, ce qui vous donne un argument concret pour décider quoi bloquer et quoi laisser explorer.
Une fois les gaspillages identifiés, vous agissez : blocage des paramètres d’URL inutiles dans le robots.txt, mise en noindex des pages à faible valeur, renforcement du maillage vers les pages prioritaires. Vous redirigez ainsi l’attention de Google là où elle compte vraiment. Je détaille la partie blocage sur mon guide du robots.txt avec Screaming Frog.
Fréquence de crawl
Voyez quelles pages Googlebot visite le plus souvent et lesquelles il néglige.
Erreurs réelles
Repérez les 404 et 500 que les bots rencontrent vraiment, pas seulement en théorie.
Budget de crawl
Mesurez le temps gaspillé sur des URLs sans valeur et récupérez-le.
Pour quels sites l’analyse de logs est-elle indispensable ?
Sur un petit site de quelques dizaines de pages, l’analyse de logs apporte peu : Google explore tout facilement. L’outil devient vraiment stratégique à partir de plusieurs milliers d’URLs, et incontournable sur les gros e-commerce ou les sites d’actualité où le budget de crawl est un enjeu quotidien. Sur un petit site, ce que les logs disent de vos vrais visiteurs et des robots des IA compte souvent plus. C’est ce que suit mon analyseur de logs. Pour un premier coup d’œil à un fichier, sans rien installer, il y a aussi l’analyseur de logs gratuit.
Les sites d’actualité et les médias sont un cas particulier : leur contenu doit être indexable en quelques minutes pour capter le trafic à chaud. L’analyse de logs leur permet de vérifier que Googlebot revient assez souvent sur les rubriques chaudes, et de détecter tout ralentissement d’exploration qui ferait rater une actualité. Pour eux, quelques minutes de délai d’indexation peuvent représenter une perte de trafic considérable.
Les sites en pleine migration ou refonte tirent aussi un grand bénéfice des logs. Après un changement de structure, vous voulez vérifier que Googlebot découvre bien les nouvelles URLs et abandonne les anciennes. Les logs vous montrent en temps réel si la migration est correctement perçue par les moteurs, là où la Search Console met parfois plusieurs jours à refléter la réalité.
Attention toutefois à ne pas surdimensionner : si votre site tient sur quelques centaines de pages bien maillées, investir du temps et de l’argent dans l’analyse de logs serait déplacé. Le bon réflexe est de commencer par un crawl propre et un maillage solide ; l’analyse de logs vient ensuite, quand la volumétrie et les enjeux le justifient vraiment. C’est un outil de maturité SEO, pas un point de départ.
Si vous gérez un site à forte volumétrie, coupler le SEO Spider et le Log File Analyser vous donne une longueur d’avance. Vous ne devinez plus le comportement de Google : vous le lisez. Sur la méthode globale, mon guide de formation Screaming Frog couvre le croisement crawl et logs.
Mon workflow d’analyse de logs, étape par étape
Voici concrètement comment je procède sur un site à analyser. Je commence par récupérer trente jours de logs, que j’importe dans le Log File Analyser. Première lecture : je regarde le volume total de requêtes Googlebot et sa répartition dans le temps, pour vérifier qu’il n’y a pas de chute brutale d’exploration, signe possible d’un problème serveur ou d’un blocage accidentel.
Ensuite, je trie les URLs par fréquence de crawl décroissante. Les pages en haut de liste sont celles que Google juge importantes : je vérifie qu’elles correspondent bien à mes pages stratégiques. Quand une page de faible valeur truste le haut du classement, c’est un signal d’alerte immédiat sur un gaspillage de budget.
Je regarde aussi la répartition des codes de réponse côté bots. Un taux anormal de 404 signifie que Google perd du temps sur des liens morts qu’il faudrait corriger ou rediriger. Une proportion notable de 301 indique des chaînes de redirection à nettoyer, car chaque saut consomme une part du budget. Ces détails, invisibles à l’œil nu, ressortent immédiatement dans un bon tableau de logs et orientent les premières corrections.
Troisième temps : j’importe mon crawl du SEO Spider pour croiser les deux jeux de données. J’isole alors deux listes critiques. D’un côté, les pages crawlables et stratégiques que Googlebot n’a jamais visitées en trente jours : elles ont un problème de maillage ou de profondeur. De l’autre, les URLs visitées par Google mais absentes de ma structure : des pages orphelines ou des restes d’anciennes versions.
Ce croisement révèle presque toujours des surprises. Des pages que l’on croyait supprimées depuis longtemps et que Google continue de visiter. Des sections entières du site jamais explorées car enfouies trop profond dans l’arborescence. Des versions paramétrées d’URLs qui démultiplient artificiellement le nombre de pages vues par les bots. Chaque anomalie devient une action concrète d’optimisation, chiffrée et priorisable.
Je répète ensuite l’opération à intervalle régulier, un mois ou un trimestre plus tard, pour mesurer l’effet des corrections. C’est l’intérêt majeur de cette méthode : elle n’est pas qu’un diagnostic ponctuel, mais un vrai suivi. Voir la fréquence de crawl des pages stratégiques augmenter après un renforcement du maillage est la preuve tangible que le travail a porté, là où la plupart des optimisations SEO restent difficiles à attribuer.
Enfin, je hiérarchise les actions. Corriger d’abord les erreurs réelles rencontrées par les bots, puis récupérer le budget gaspillé sur les URLs inutiles, puis renforcer le maillage vers les pages sous-explorées. Ce trio d’actions, mené dans cet ordre, donne généralement des résultats visibles sur l’indexation en quelques semaines. Sur le volet maillage, mon guide du maillage interne complète cette approche.
Mesurez l’effet de vos corrections sur vos positions
Les logs montrent ce que Google explore. Semrush suit vos positions et vos mots-clés, pour voir si les pages mieux explorées gagnent aussi des places dans les résultats. L’essai gratuit de 7 jours donne accès aux formules payantes, puis Semrush démarre à 139,95 $ par mois.
Lien partenaire : si vous vous abonnez, je touche une commission, sans surcoût pour vous.
Les limites à connaître
L’analyse de logs demande un minimum de rigueur technique. Il faut savoir récupérer les fichiers, comprendre leur format, et disposer d’un historique suffisant. Certains hébergeurs conservent les logs peu de temps ou les rendent difficiles à exporter, ce qui complique l’analyse sur la durée.
Un autre piège fréquent : la présence d’un cache ou d’un CDN devant votre serveur. Si un service comme un CDN intercepte une partie des requêtes, vos logs d’origine peuvent être incomplets : certaines visites de Googlebot sont servies par le cache et n’atteignent jamais votre serveur. Dans ce cas, il faut récupérer les logs au bon niveau, souvent ceux du CDN lui-même, sous peine d’analyser une image partielle et trompeuse de l’exploration.
Il faut enfin composer avec le volume. Sur un site à fort trafic, un mois de logs peut représenter des centaines de millions de lignes et plusieurs gigaoctets de données. Le Log File Analyser gère bien ces volumes, mais l’import et l’indexation prennent du temps et sollicitent votre machine. Sur les cas vraiment massifs, c’est d’ailleurs là que les solutions cloud d’analyse de logs reprennent l’avantage, en traitant les données sur leurs propres serveurs.
Autre point : les logs bruts ne contiennent pas les données JavaScript ni les interactions front. Ils enregistrent les requêtes serveur, pas le rendu final. C’est pourquoi ils se combinent avec un crawl, jamais seuls. Ensemble, les deux donnent une image complète ; séparément, chacun a ses angles morts.
Mon verdict sur le Log File Analyser
Le Screaming Frog Log File Analyser n’est pas un gadget : c’est l’outil qui transforme le SEO technique en science exacte. Là où le crawl suppose, les logs prouvent. Pour tout site dépassant quelques milliers de pages, c’est l’investissement qui révèle les gaspillages invisibles et redirige le budget de crawl vers ce qui compte.
Mon conseil pour démarrer : commencez par un simple export de logs sur sept jours, importez-les et regardez d’abord les pages les plus crawlées. Vous serez souvent surpris de voir Google passer du temps sur des URLs que vous croyiez sans importance.
Un site solide avant les outils
Un site bien construit gaspille moins de budget de crawl. Je crée des sites WordPress clairs et rapides, pour les indépendants et les petites entreprises : un site vitrine commence à 1 500 € HT. Tout est expliqué sur la page création de site internet.
Questions fréquentes sur le Log File Analyser
Une autre question ? Décrivez votre projet, on vous répond par mail.
Le Log File Analyser est-il inclus dans le SEO Spider ?
Non, ce sont deux logiciels distincts, vendus séparément. Le SEO Spider crawle votre site ; le Log File Analyser lit vos logs serveur. Ils se complètent mais s’installent et s’achètent indépendamment.
Chacun possède sa propre version gratuite limitée, ce qui vous permet de tester le Log File Analyser avant d’investir. Si votre site est petit, vous n’aurez peut-être jamais besoin de la version complète de ce second outil.
Où trouver mes fichiers de logs serveur ?
Sur un hébergement mutualisé, dans le panneau cPanel, rubrique « Logs bruts ». Sur un serveur dédié ou VPS, dans les répertoires standard d’Apache ou de Nginx. Votre hébergeur peut vous guider si besoin.
Attention si vous utilisez un CDN ou un cache devant votre serveur : une partie des requêtes de Googlebot peut être servie par le cache et ne jamais atteindre votre serveur d’origine. Dans ce cas, récupérez les logs au niveau du CDN pour disposer d’une image complète de l’exploration.
À partir de quelle taille de site l’analyse de logs est-elle utile ?
À partir de plusieurs milliers d’URLs, l’analyse devient réellement stratégique. En dessous, Google explore tout facilement et le gain est marginal. Sur les gros e-commerce, elle est indispensable.
Les sites d’actualité et les projets en migration font exception : même à volumétrie plus modérée, la vitesse et la fiabilité d’exploration y sont critiques, et les logs sont le seul moyen de les contrôler précisément.
L’analyse de logs remplace-t-elle le crawl ?
Non, elle le complète. Le crawl montre ce que votre site expose ; les logs montrent ce que Google explore vraiment. Croiser les deux donne la vue la plus fiable pour piloter votre budget de crawl.
En pratique, je commence toujours par un crawl du SEO Spider pour cartographier la structure, puis j’importe les logs pour confronter cette théorie à la réalité d’exploration. L’un sans l’autre laisse toujours des angles morts : le crawl ne voit pas ce que Google fait, les logs ne voient pas ce que votre site pourrait proposer.
Combien de jours de logs faut-il pour une analyse fiable ?
Sept jours au minimum, trente idéalement. Sur une seule journée, les chiffres de fréquence sont trop bruités. Sur un mois complet, les tendances se lissent et vous voyez vraiment quelles sections Googlebot privilégie ou délaisse.
Si votre hébergeur efface les logs rapidement, prenez l’habitude de les archiver régulièrement pour disposer d’un historique suffisant le jour où vous voudrez analyser.
Le Log File Analyser voit-il le JavaScript ?
Non. Les logs bruts enregistrent les requêtes serveur, pas le rendu final ni les interactions front. C’est précisément pour ça qu’on les combine avec un crawl : ensemble, les deux donnent une image complète ; séparément, chacun a ses angles morts.
Comment savoir si Googlebot mobile explore bien mon site ?
L’analyse de logs permet de filtrer par type de bot. Depuis l’index mobile-first, vérifier que Googlebot mobile visite bien vos pages stratégiques est un contrôle essentiel, et les logs sont le seul moyen de le mesurer précisément, URL par URL.
Si vous constatez que Googlebot mobile explore beaucoup moins que sa version desktop, c’est souvent le signe d’un problème de rendu ou de performance sur mobile. Les logs vous donnent l’alerte ; le crawl et un test de rendu vous aident ensuite à en identifier la cause précise.
Peut-on automatiser l’analyse de logs dans le temps ?
Oui, c’est même l’idéal sur les gros sites. En archivant automatiquement vos logs et en les réimportant à intervalle régulier, vous transformez l’analyse ponctuelle en suivi continu. Vous voyez alors l’effet de chaque optimisation sur la fréquence de crawl, mois après mois.
Ce suivi dans la durée est ce qui distingue une vraie démarche SEO technique d’un audit isolé. Voir la courbe de crawl des pages stratégiques monter après un renforcement du maillage est la preuve concrète que votre travail porte ses fruits.
Ce que disent mes clients
Des avis publiés sur Google et des recommandations publiées sur LinkedIn.
« Simple et efficace, Lucas à compris à merveille le besoin de mon activité pour me faire un site internet au top et dans un temps record. »
« Je recommande vivement Lucas. Il a réalisé la refonte complète de mon site (…) Professionnel et efficace, je suis ravi de cette collaboration. Merci ! »
« (…) Il est bien réel, disponible, efficace et humain ! Il prend soin de la visibilité de notre petite association. (…) »
« Lucas est un expert de la création d’entreprise et de tous les orbites qui tournent autour. (…) il a pressé mon jus de crâne pour la bonne cause tout en m’inspirant. Merci Lucas que je recommande vivement :) »
« Lucas est super efficace (…) Au delà d’être agréable et gentil, il cerne les problématiques très rapidement. (…) J’ai beaucoup apprécié sa pédagogie (…) »
« Lucas est un élément brillant et transmet une belle énergie à tout groupe de travail. Nous avons travaillé ensemble sur des sujets communs et organisationnels de nos entreprises respectives. Merci à lui pour ses idées disruptives. A très vite »
« (…) Très attaché à la qualité et aux résultats, Lucas sait se montrer ambitieux et donner le meilleur pour aller au bout de ses projets. (…) »
« Je tiens à recommander Lucas pour son professionnalisme. (…) »
Des avis publiés, pas inventés
Les avis Google ont tous reçu cinq étoiles. Les recommandations viennent de LinkedIn. Tout est repris tel que les personnes l’ont écrit. Quand un passage est coupé, il est signalé par (…).
À lire aussi
Lucas Fonseque, créateur de sites web
Je suis entrepreneur, et je travaille dans le digital depuis dix ans. J’ai d’abord appris à programmer. Puis j’ai lancé mes propres projets : une marque, des boutiques en ligne, une plateforme, une communauté de plus de 600 entrepreneurs, une application. Je sais comment le web fonctionnait hier, et comment il fonctionne aujourd’hui.
J’ai travaillé pour des indépendants, des petites entreprises, des start-up et des grands comptes. Je me tiens à jour en permanence, parce que les outils changent vite. C’est toute cette expérience que vous retrouvez dans votre site. Vous pouvez lire mon histoire en entier, voir mes réalisations ou parcourir tous mes services.
Un site à créer ou à refaire ?
Vous n’avez rien à préparer. Décrivez votre projet en deux minutes, on vous répond par mail.
Vous décrivez votre projet. Deux minutes suffisent.
On vous répond par mail, puis on voit ensemble la suite.
Vous recevez un devis détaillé et gratuit, sans engagement.